大学院生はAIをどのように活用すれば、一線を踏み外さないようにするべきか: 学術的誠実性を維持するための実践的なガイド
有名な学術的完全性追跡ウェブサイト Retraction Watch は、2025 年 12 月 2 日、「倫理ジャーナルにおける偽の参考文献の事例(新しいタブで開く)」と題する詳細な報告書を発表しました。国際的に有名な出版社 Springer Nature が発行する「Journal of Academic Ethics(新しいタブで開く)」(Journal of Academic Ethics) では、少なくとも 19 件の捏造が判明しました。 29 件中参考文献があり、Google Scholar リンクのうち 18 件はすべて空でした。ブラックユーモアはここにある。問題は著者が倫理を理解していなかったことではなく、AIが生成した引用を、一つ一つ検証するという何のこともせずに直接送信したことにある。
ここは自分から遠いものだと感じるかもしれません。しかし、同年11月、香港大学の学者と博士課程の学生が共著した人口統計の論文が、AIによって発明された幽霊文書(新しいタブで開く)を広範囲に引用していたことが明らかになった。 その後、香港大学が調査に介入し、12月に処分結果を発表した。また、修士論文に彼が書いたことのない著作が引用されていたことを台湾の学者が発見したことも報告されている。 この人たちは誰も捏造したいわけではなく、自分で下すべき判断をモデルに委託しているだけなのです。
前回の文献レビューで、AI によって発見されたものの、原文をクリックして確認しなかった引用が何件あるか数えたことはありますか?
この記事が伝えたいことは境界線です
AI を使用してより速く書く方法について話すつもりはありません。 私が話したいのは別のことです。 生産性を高め、学術的誠実性を維持するために、論文のあらゆる側面で AI をどの程度使用できるかということです。 読んだ後は、明確な境界線と、従うべき一連の分業原則がわかるでしょう。
率直に言って、大学院生にとっての AI 活用の本当の課題は、AI を速くできるかどうかではなく、どのリンクをどの程度まで使えるかということでした。
行動を起こす前に: まず三者間の合意を書き留めてください
AI ツールを使用する前に、学術界の収益を念頭に置いてください。 これは一学術誌のルールではなく、この分野全体の共通前提です。
COPE (出版倫理委員会)(新しいタブで開く) は、2023 年に次のことを明確にしました。 AI ツールは投稿に対して責任を負えず、利益相反と著者権に対処できないため、著者性を満たすことができません。 ICMJE、エルゼビア、およびネイチャーの一般的なポリシーは一貫しています。 つまり、AI を著者として指名することはできず、その使用は開示されなければならず、研究者はすべてのコンテンツに対して最終的な責任を負います。台湾も例外ではありません。 文科省学術倫理教育リソースセンター(新しいタブで開く) では、検証、著作権、個人情報保護、過度の依存の回避、自己開示の 5 つの主要な考慮事項を提案しています。 米国学術会議の利用ガイドラインでは、その政策要件に従って、AI の出力を完全に信頼することはできず、最終的な判断は人間の独立した思考に取って代わることはできないと述べています。
この段落全体を、画面の端に貼り付けることができる 1 つの原則に凝縮します。つまり、AI は虫眼鏡であり、代替品ではありません。検証性と説明責任は永久に残ります。
5 つのリンク、境界はどこに引かれますか?
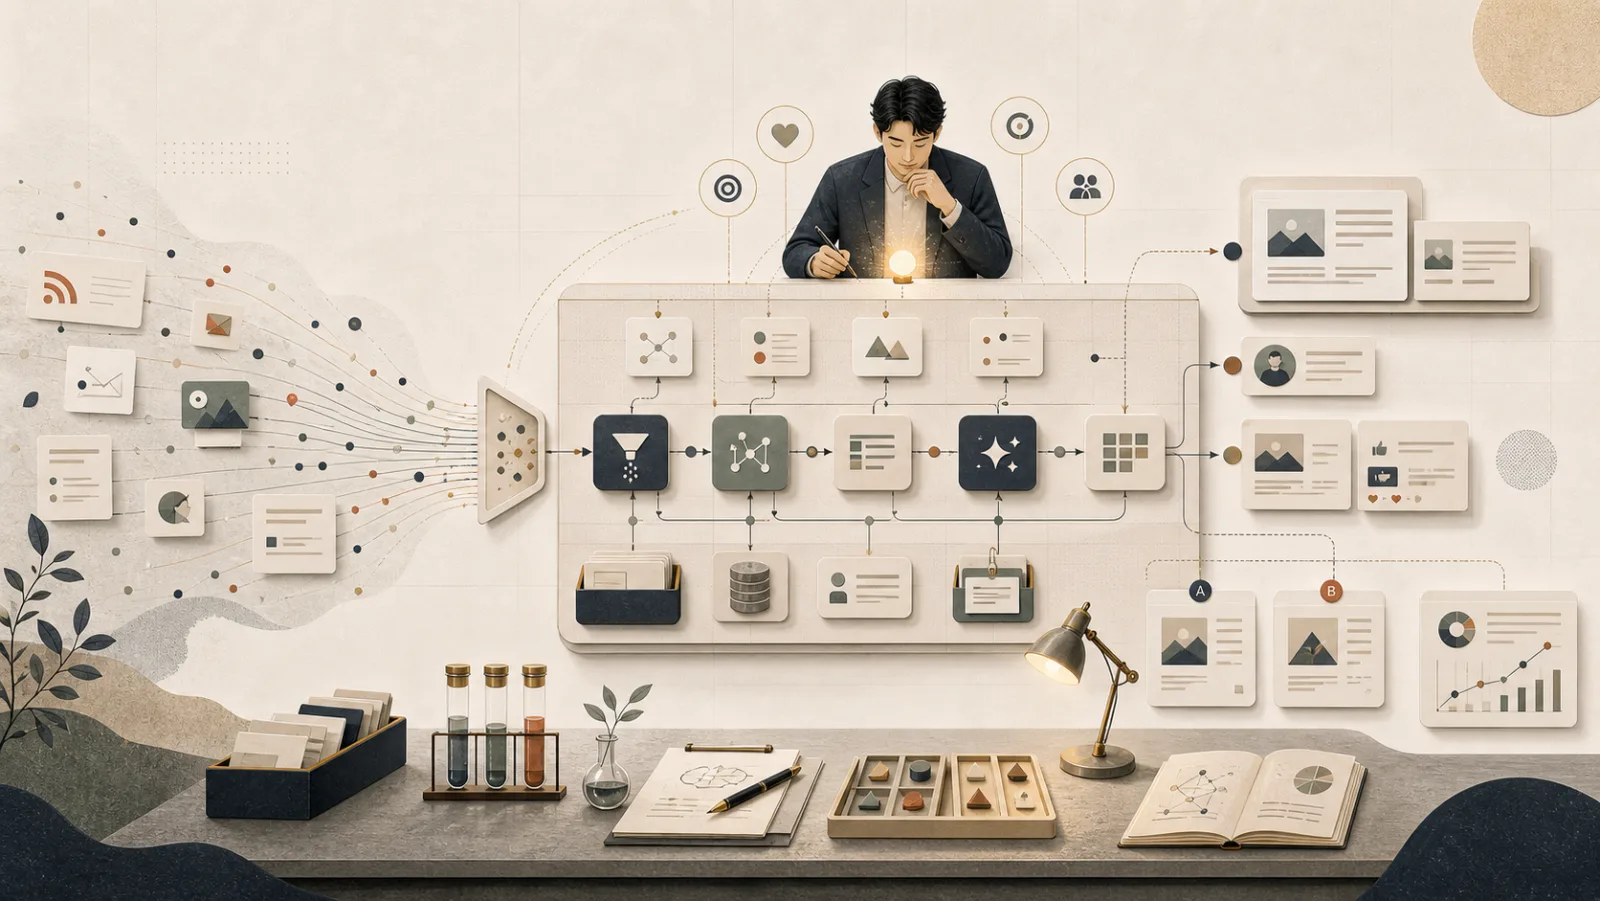
次に、リンクごとに見て、この線をどこに引くべきかを見てみましょう。
ステップ 1: 文献の探索。 その後の読み物を見つけるためにそれを使用します。判断を外注しないでください。
AI を利用して、大量の文書を要約に凝縮し、異なる学派間の論争を整理し、思いつかなかったキーワードを拡張するのに役立ちます。これらはすべて非常に便利です。ただし、ここには赤線があります。 AI が直接吐き出す参考文献リストは、検証待ちとして扱われ、引用の準備ができていないものとして扱われるべきです。
前の数字は怖がらせるためのものではありません。 初期の研究では、ChatGPT-3.5 によって生成された文献レビューの参考文献の約 55% が捏造されており、たとえ GPT-4 に切り替えられたとしても 20% 近くが依然として間違っていることが判明しました。 引用するたびに、元のデータベースに戻り、元のテキストをクリックして、それが実際に存在し、本当にその内容が書かれていることを確認する必要があります。
ステップ 2: デザインを調査し、代替品ではなく、弁証法上のパートナーとして扱います。
このステップは、AI を最も重要なレビュー担当者として機能させる場合に最適です。 研究の質問を投げかけて、「この質問はなぜ重要ですか?」と質問してもらいます。 変数は内生的ですか?あなたが思いつかなかった別の説明はありますか?
盲点の発見を支援することの価値は、設計の生成を支援することよりもはるかに大きくなります。 デザイン自体については自分で決定する必要があります。結局のところ、口頭面接の席であらゆる選択を守るのはモデルではなくあなたです。
ステップ 3: データ分析、支援は可能、製造は不可能
AI を利用して、逐語的なドラフトを仮のコーディングに整理し、統計結果を現地語に翻訳し、前後のコーディングの不一致をチェックします。これらはすべて妥当な加速です。 ただし、絶対にやってはいけないルールが 1 つあります。それは、情報を装飾したり完全にしたりしないことです。 データがどのようなものであるかはわかりません。ただ、妥当と思われるデータが生成されるだけです。 これらの結果が論文に掲載されれば、それはあなたの名前になります。
ステップ 4: 執筆と開示、研磨とゴーストライティングの区別
言語磨きとゴーストライティングの境界線はどこにあるのでしょうか? 私の判断は次のとおりです。アイデア、議論、構造はあなたのものであり、AI はそれらをいかにわかりやすく説明するかだけを気にします。これは装飾と呼ばれます。引数を生成するだけでも、この一線を超えています。
磨いた後は、忘れずに明らかにしてください。 暴露することは自白ではなく、他の人が再現してテストできるように、何をどこで使用したかを明らかにすることです。 ほとんどの学術機関や学術雑誌の要件は、一文に要約できます。つまり、AI の恩恵を受ける研究のすべての部分を説明できなければならず、たとえ明確に説明できない段落があってはなりません。
この部分について特に話したいのは、この部分がコースの開始以来、私が最も頻繁に聞かれた質問だからです。 AI アカデミック ライティング コース(新しいタブで開く) では、ほぼすべての大学院生が同じことを私に尋ねました。特に英語の段落を磨くために AI を使用しても大丈夫ですか?それともAIが介入した時点でゴーストライティングとしてカウントされるのでしょうか? 誰もが本当にこだわっているのは、それを使用するかどうかではなく、このレベルでどこに線を引くかということです。 私の答えは依然として前の文に戻ります。 表現に関するものであれば、それはまだ磨きの面にあります。アイデアや議論に触れている場合、それは不適切であり、あなた自身がそれを検討する必要があります。
ステップ 5: 提出物と口頭試験、スパーリング パートナーにしましょう
これは最も過小評価されている AI の使用法です。 論文を投稿する前に、対象ジャーナルの査読者をシミュレートして論文の拒否レターを書いてもらうように依頼してください。最も可能性の高いポイントが最初にリストされるので、時間をかけてそれらを補うことができます。 面接の前に、彼に最も難しい口頭弁護をさせて、あなたに 3 ラウンドの質問をし、あなたの主張のストレステストを強制します。
この使用法は誠実さをまったく損なうものではありません。最終的にステージに立って答えるのはあなた自身だからです。 覚えておいてください: AI は単なるトレーニング パートナーであり、受験者ではありません。
最もよくある 3 つの質問
**AI が使用されている場合、それについて話すべきでしょうか?私が十分に独立していないように見えるでしょうか? **
逆に考えてみてください。 隠して伝えないと、バレたら致命的です。 研究では、2024 年には論文の少なくとも約 10% に大規模な言語モデル処理の痕跡が残ると推定されていますが、それらが暴露されることはほとんどありません。 このため、さまざまな企業がポリシーを強化しています。 それを積極的かつ明確に公開することは、研究が十分に厳密であることの証拠となります。
**反対派は、AI が研究や訓練に悪影響を与えると主張しています。 これは本当ですか? **
それは本当です、あなたは正直にそれに直面しなければなりません。マサチューセッツ工科大学(MIT)メディア研究所の科学者ナタリヤ・コスミナ氏が2025年6月に発表した研究「Your Brain on ChatGPT(新しいタブで開く)」では、大規模言語モデル(LLM)を使用したときの人間の脳波反応を調査した。 研究によると、大規模な言語モデルを使用する人は脳領域のつながりが最も弱く、自分の作品に対する当事者意識が最も低く、自分が書いたものを正確に引用することさえ難しいことがわかっています。研究者たちはこれを「認知的負債」と呼んでいます。
しかし、これはそれを使用しない理由ではなく、使用する理由です。 これらの調査結果が実際に示していることは、判断、批判、または議論の最も重要な側面を外部委託することは、研究能力の開発を短絡することに等しいということです。 したがって、ここで線が引かれています。自分の頭を使う価値があるかどうかは自分に任せてください。 AI に任せることを検討できるのは、用事を済ませたり、検索や翻訳をしたりするときだけです。
**ジャーナルによって規制が異なります。 どのように対応すればよいですか? **
AI は匿名であってはならず、公開されなければならず、全責任は人間にあるという最低限のコンセンサスを覚えておいてください。 詳細はさまざまで、講師からの事前の承認が必要なものもあれば、事後の開示のみが必要なものもあります。 投稿する前に対象ジャーナルの元の AI ポリシーを 10 分かけて読むほうが、すべてのルールを暗記するよりもはるかに実用的です。
次のステップ: 今日はこの小さな演習を行ってください
この記事から 1 つのことだけを取り上げたい場合は、次の文を削除してください。AI を有効に活用するための最高基準は、内容のすべての段落を説明でき、すべての文書を見つけることができ、名前を知っている人がそれを買う余裕があることです。
執筆中の原稿を開き、AI が生成または書き換えたすべての段落を見つけて、これら 3 つの質問を 1 つずつ自分に問いかけてください。 答えられないことがあれば、それはそれを実際に自分の研究に落とし込んでいないことを意味します。
一番自分の頭を使う部分は任せてください。この部分は自分で行う必要があります。
この一連の境界線を論文投稿前にチェックできるチェックリストにしたい場合は、論文を投稿する前に、すべての引用が見つかり、すべての段落が明確に説明されており、指名された人が段落ごとにそれを行う余裕があるかどうかを確認するのに役立つ「AI 学術的誠実性セルフチェックリスト」を作成しました。 無料で入手するにはここをクリック へようこそ。この境界をあなたの研究ルーチンに組み込んでください。